Генерация и отбор четырьмя большими языковыми моделями научных гипотез, совпадающих с опубликованным экспериментальным результатом, в бенчмарке на 50 статьях по биологии старения
Препринт. Редакция от 31 октября 2026 года. Рукопись не проходила рецензирование.
Автор: Юрий Потешкин¹. [Состав соавторов и порядок авторов уточняются.]
¹ Open Longevity, проект Eternal Search, Шерман-Окс, Калифорния, США.
Автор для переписки: Юрий Потешкин; вопросы по работе направляются через форму обратной связи Eternal Search. [Если журнал требует адрес электронной почты в рукописи, он добавляется в файл подачи, а не в публичную версию.]
Аннотация§
Постановка задачи
Определить, как часто гипотезы больших языковых моделей по 50 исследовательским задачам со скрытым ответом совпадают с опубликованным экспериментальным результатом, и проверить, можно ли по прогнозам моделей отобрать совпадающие гипотезы.
Методы
По 50 рецензированным статьям о биологии старения, опубликованным после заявленных дат окончания обучения моделей, мы составили задания из исходных сведений и вопроса. GPT-6 Astra, Grok 4.5, Claude Opus 5.5 и Gemini 4 Argon предлагали по пять гипотез одним запросом, многоступенчатой схемой и схемой Omega Point без поиска литературы (2997 гипотез). Совпадение с эталоном определяли большинством из трёх моделей-судей других компаний при балле не ниже 3 (основной порог) или не ниже 4 (строгий порог) по шкале 0–5. Двухэтапное правило, выбранное из 112 вариантов на гипотезах Grok 4.5, исключало гипотезы с прогнозом «нет» от GPT-6 Astra и сохраняло гипотезы с прогнозом «да» всех четырёх прогнозирующих моделей; результат статьи эти модели не получали. Контролем служили сохранённые случайные ответы; 95 % доверительные интервалы (ДИ) рассчитывали кластерным бутстрепом по задачам. Различение исходов проверяли на наборе из 50 подтверждённых и 50 опровергнутых утверждений.
Результаты
С эталоном совпадали 13,2–18,0 % гипотез, полученных одним запросом, 11,2–18,8 % при многоступенчатой схеме и 2,8–7,6 % при схеме Omega Point. На наборе 50/50 сбалансированная точность моделей составила 71,0–78,0 % (случайного контроля 52,0 %), а прогностическая ценность положительного результата (PPV) при единогласии пяти моделей 88,5 % (23/26); при доле совпадений, наблюдавшейся в наборе генерации, расчётная PPV составляет 53,8–62,7 %. После двухэтапного отбора с эталоном совпадали 73,7 % (14/19) отобранных гипотез Grok 4.5, 47,4 % (9/19) Gemini 4 Argon и 63,6 % (14/22) Claude Opus 5.5 при 12,1–17,9 % у случайного контроля; в списки вошли 27,3–35,0 % всех совпадающих гипотез. При строгом пороге доля совпадений среди отобранных составила 9,1–31,6 %.
Выводы
На исследованных наборах двухэтапный отбор повышал долю гипотез, совпадающих с опубликованным результатом; величина этой доли зависит от порога совпадения. Правило выбрано на тех же данных, и его преимущество перед лучшей одиночной моделью при равной длине списка подтвердилось для двух генераторов из трёх. Применимость правила предстоит проверить на новых задачах.
Ключевые слова: большие языковые модели; генерация научных гипотез; биология старения; бенчмарк; прогноз экспериментального подтверждения; прогностическая ценность; согласие моделей; отбор гипотез.
1. Введение§
1.1. Генерация и отбор гипотез для проверки
Большие языковые модели генерируют научные гипотезы в количестве, многократно превышающем возможности экспериментальной проверки. Поэтому помимо генерации нужно оценивать, способны ли модели выделять среди сгенерированных гипотез те, которые с наибольшей вероятностью подтвердятся.
Мы поставили две задачи: определить, как часто модели, получив исходные сведения и исследовательский вопрос, предлагают гипотезы, совпадающие с результатами 50 опубликованных экспериментальных исследований, и проверить, могут ли модели прогнозировать экспериментальное подтверждение готовых гипотез без доступа к результату статьи. Ответы «да» и «нет» дополнительно проверяли на отдельном наборе подтверждённых и опровергнутых утверждений.
1.2. Существующие подходы к оценке гипотез
Научную гипотезу оценивают тремя способами: судьи рецензируют её текст, гипотезу сопоставляют с уже опубликованным результатом или выполняют предложенное исследование.
В LiveIdeaBench модели получают ключевое слово и предлагают идеи, а другие модели оценивают их оригинальность, осуществимость и другие свойства 1. Такой подход применим к идеям, для которых экспериментальных данных ещё нет, однако балл отражает мнение судей, а экспериментальное подтверждение не проверяется.
В MOOSE-Chem модели получают исходные сведения и литературу, предшествующую выбранному исследованию, и проверяется, предложат ли они гипотезу, совпадающую с его результатом 2. В ResearchBench по публикациям составлены задания на поиск источников идей, формулирование и ранжирование гипотез 3. Эталоном служит опубликованная гипотеза, скрытая от модели. Низкое совпадение с эталоном оставляет открытым вопрос о том, подтвердится ли альтернативная гипотеза в другом исследовании.
В BrainBench модель выбирает исходную аннотацию из пары, в которой у второй аннотации изменён результат, в том числе обращено направление эффекта, а методы и исходные сведения сохранены. Модели выбирали текст с меньшей перплексией. На 200 заданиях, составленных экспертами, средняя доля верных выборов составила 81,4 % у 15 моделей и 63,4 % у 171 нейробиолога (t(14) = 25,8; p < 0,001) 10. Наш набор 50/50 также противопоставляет опубликованный результат изменённому, но формат предъявления и правило ответа различаются (раздел 2.6), поэтому доли верных ответов напрямую несопоставимы.
В работе 4 43 специалиста выполнили исследования по предложенным идеям, затратив в среднем 103 часа на проект, после чего результаты оценили рецензенты. В Co-Scientist генерацию, критику и уточнение гипотез дополняет лабораторная проверка отдельных гипотез 5. Результат эксперимента характеризует конкретное утверждение в условиях, в которых его проверяли.
Мы оценивали генерацию по совпадению со скрытым эталоном, а прогнозы готовых гипотез по тому же критерию. Отбор считали результативным, если доля совпадений среди отобранных гипотез превышала долю в исходном наборе и у случайного контроля. Набор подтверждённых и опровергнутых утверждений позволил проверить и ответы «нет» по известным экспериментальным исходам.
1.3. Происхождение работы
Схема Omega Point разработана в Open Longevity для генерации научных гипотез последовательными запросами с заданными творческими ролями. Исследование выполнила команда Eternal Search, отдельного проекта Open Longevity, которая в разработке Omega Point не участвовала. Работа началась со сравнения Omega Point с генерацией одним запросом и многоступенчатой схемой; затем в неё включили прогнозирование экспериментального подтверждения готовых гипотез и отбор гипотез для первоочередной проверки. Набор 50/50 разработан независимо от BrainBench.
1.4. Вклад работы
- Задачи со скрытым экспериментальным результатом. По 50 статьям о биологии старения составлены задачи для генерации гипотез; даты публикаций и препринтов проверены относительно заявленных границ обучения моделей.
- Проверка отрицательных прогнозов. Составлен набор подтверждённых и опровергнутых утверждений, позволяющий оценивать ответы «нет» по известным результатам экспериментов.
- Правило отбора гипотез. Правило исключает гипотезы с ответом «нет» одной модели и требует единогласия группы из четырёх прогнозирующих моделей; выбранное на гипотезах одного генератора, оно применено к гипотезам двух других.
2. Материалы и методы§
2.1. Отбор статей и составление заданий
Поиск в PubMed выполнили 13 октября 2026 года (выгрузка датирована 01:31:11 UTC). Запрос по биологии старения ограничивал поиск 15 журналами, типом публикации journal article и датой поступления записи в PubMed с 1 августа по 12 октября 2026 года; полный запрос приведён в приложении И. Из 284 записей предварительный фильтр исключил 42 из-за найденного раннего препринта и 30 из-за аннотации короче 600 символов или даты публикации до начала окна; осталось 212 кандидатов. Порядок рассмотрения кандидатов задали детерминированно по хэшу идентификатора PubMed (приложение М.7).
При формировании итогового набора проверяли пригодность задания, скрытие результата и наличие ранних препринтов (рис. 1). Итоговые 50 задач не составляют случайной выборки из 212 кандидатов. Сведения о поиске, исключениях и порядке кандидатов опубликованы в журнале отбора, полнота журнала рассмотрена в приложении И.
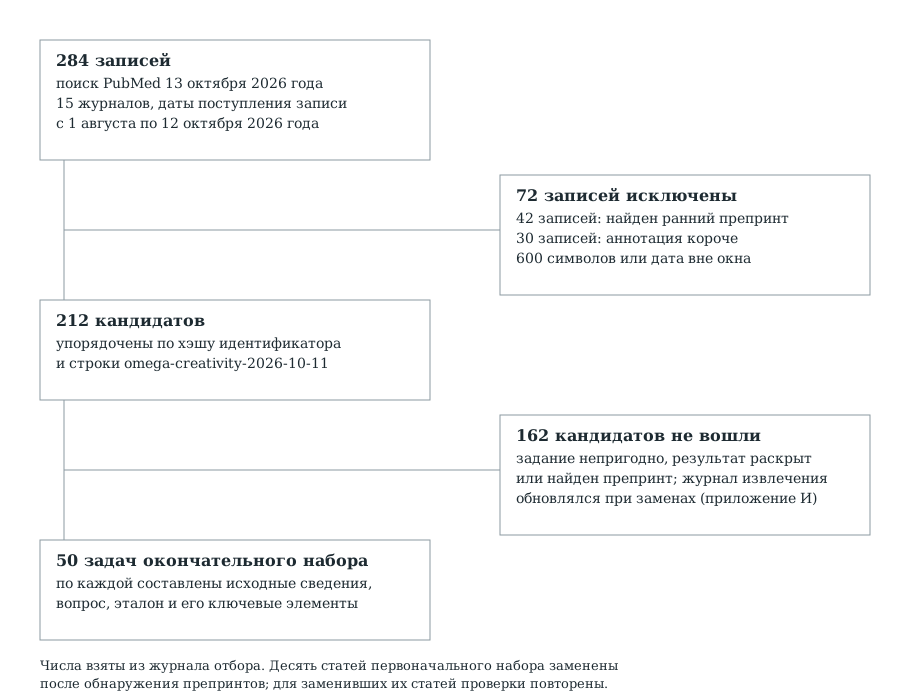
Рисунок 1. Отбор статей для заданий бенчмарка
Предварительный фильтр исключил 72 записи из 284. Из 212 кандидатов в итоговый набор вошли 50 задач. Промежуточные журналы извлечения обновлялись при заменах, поэтому причины исключения остальных 162 кандидатов по ним не восстанавливаются (приложение И).
В итоговый набор вошли 50 рецензированных статей, впервые опубликованных с 1 августа по 9 октября 2026 года (20 в августе, 20 в сентябре и 10 в октябре): Aging Cell (22 статьи), Science Advances (10), Nature Aging (8), Nature Communications (6), PNAS, Science, Neuron и Immunity (по одной).
Соответствие временному ограничению определяли по дате первой публичной версии исследования, включая препринт. Ранние версии искали шестью способами: по ссылкам на препринты в PubMed, записям о размещении публикации на серверах препринтов в OpenAlex, связям has-preprint в Crossref, поиску по авторам в Europe PMC, записям posted-content в Crossref и отдельному поиску препринтов в OpenAlex. Найденные версии сопоставляли со статьёй по названию и аннотации с учётом возможной смены названия. Десять статей первоначального набора имели препринты, опубликованные до общей временной границы; их заменили и для новых статей повторили проверку дат, генерацию гипотез и оценку судей. Перепроверка итогового набора завершена 19 октября 2026 года; поиск ранних версий ограничен перечисленными источниками и этой датой.
По полной аннотации PubMed модель GPT-5.6 Sol составляла исходные сведения, исследовательский вопрос, эталонное утверждение и перечень его ключевых элементов. Эталонным утверждением (далее эталоном) называли результат эксперимента, сообщённый в рецензированной статье. GPT-5.6 Terra проверяла, не раскрывают ли исходные сведения и вопрос эталон. Модель-генератор получала только исходные сведения и вопрос.
2.2. Модели
Гипотезы генерировали GPT-6 Astra (далее Astra), Grok 4.5 (Grok), Claude Opus 5.5 (Opus) и Gemini 4 Argon (Gemini) с высоким бюджетом токенов на рассуждение. Лимит составлял 32 000 токенов на одно обращение к модели, был общим для рассуждения и ответа и одинаковым для всех моделей и способов генерации. Прогнозирующими моделями служили Claude Sonnet 5.5 (Sonnet), Astra, Gemini и Grok, в отдельных вычислительных экспериментах также Opus, Claude Haiku 5.5 и Claude Opus 4.8. Условия запуска моделей в каждой роли приведены в приложении М.1.
Заявленные даты окончания обучения: Grok — январь 2026 года, Gemini — март 2026 года, Astra — 30 апреля 2026 года, Opus и Sonnet — июнь 2026 года. Разработчики называли эти даты границами знаний модели или данных предобучения; при отборе задач использовали заявленные даты. Судьи получали эталон явно, поэтому временное ограничение к ним не применяли.
Все модели работали со своими значениями параметров выборки (температуры и усечения распределения) по умолчанию. Начальное значение генератора случайных чисел модели не поддерживают, поэтому воспроизводимость обеспечена сохранёнными ответами. Запрос повторяли, если ответ не удавалось разобрать или модель отказывалась отвечать; технические ошибки передачи в число попыток не входят. Идентификаторы моделей, настройки, запросы и ответы сохранены в журналах.
2.3. Способы генерации
Один запрос (в данных обозначен N). Модель получала исходные сведения, вопрос и просьбу предложить пять гипотез в одном ответе.
Многоступенчатая схема (A). Модель последовательно анализировала задачу, предлагала и развивала объяснения, затем отбирала пять гипотез. Творческие роли Omega Point в эту схему не включали. Дополнительными запросами число сгенерированных токенов приближали к расходу Omega Point.
Схема Omega Point (O). Использовали сокращённую версию из пяти ступеней без поиска научной литературы: анализ нарушений работы системы, описанной в задании; поиск противоречий и связей с другими областями; постановка вопросов о пробелах в знаниях; генерация гипотез с позиций заданных творческих ролей; развитие выбранных гипотез и итоговый отбор.
Сгенерированными токенами считали зарегистрированные токены ответа и скрытого рассуждения без входных токенов запроса; фактический расход приведён в разделе 3.1.
При генерации гипотез Opus срабатывал классификатор безопасности Claude. Мы принимали полученные ответы и не пытались обойти защиту. Отказ засчитывали как несовпадение с эталоном: набор, который модель не сгенерировала ни в одной попытке, учитывали как пять несовпадающих гипотез, недостающие гипотезы неполного ответа учитывали так же. Знаменатель каждого режима составлял 250 гипотез; всего сохранено 2997 гипотез.
Оригинальность сравнивали на отдельном наборе из 100 научных ключевых слов в адаптации LiveIdeaBench. Каждая модель предлагала по две идеи на ключевое слово; судьи оценивали оригинальность по шкале 1–10, а также осуществимость, ясность и различие двух идей.
2.4. Судьи и определение исхода
Судьями служили GPT-5.6 Sol, Grok 4.7, Claude Opus 5.5 и Gemini 4 Argon со средним уровнем рассуждения (reasoning = medium). Исход гипотезы определяли три судьи других компаний: судью компании, разработавшей генератор, исключали. Судья получал исходные сведения, вопрос, эталон с ключевыми элементами и полный текст гипотез и ставил балл по шкале соответствия эталону:
| Балл▲ | Соответствие эталону▲ |
|---|---|
| 0 | Связи нет или гипотеза противоречит эталону |
| 1 | Слабая связь с эталоном |
| 2 | Совпадает тема, но причинное утверждение отличается |
| 3 | Верно названы основной механизм или мишень; важные элементы результата упущены |
| 4 | Совпадает центральное утверждение; упущен не более чем один второстепенный элемент |
| 5 | Совпадают причинное утверждение и все ключевые элементы |
Гипотезу считали совпадающей с эталоном, если не менее двух из трёх судей поставили ей балл не ниже 3 (основной порог). Основной порог требует совпадения механизма или мишени и допускает пропуск важных элементов результата. Строгий порог требовал балла 4 или 5 не менее чем от двух судей. Решение большинства определяли отдельно для каждого порога, баллы не усредняли. Балл ниже порога означает расхождение с эталоном; экспериментального опровержения гипотезы из него не следует. Эталоны, шкала и баллы четырёх судей опубликованы, поэтому любую гипотезу может повторно оценить другой судья.
Согласие судей рассчитали для бинарного голоса «балл 3 и выше», от которого зависит исход при основном пороге; все четыре судьи оценили каждую из 2997 гипотез. Каппа Коэна в шести парах судей составила 0,70–0,77, каппа Флейса для трёх судей, определявших исход, 0,72 (95 % ДИ [0,67; 0,77]). Решение большинства по 283 гипотезам (9,4 %) изменилось бы при смене одного голоса. Для голоса «балл 4 или 5» каппа Коэна в парах составила 0,47–0,72, каппа Флейса 0,57 (95 % ДИ [0,41; 0,67]). Распределение голосов и взвешенная каппа приведены в приложениях К и М.2.
2.5. Прогнозирование: подробная инструкция и короткий вопрос
Бенчмарк прогнозирования не зависит от генерации: на вход подаются готовые гипотезы любого происхождения. Два варианта запроса сравнили на 250 гипотезах, которые Astra сгенерировала одним запросом по 50 задачам. Прогнозирующие модели Sonnet, Astra, Gemini и Grok получали в одном запросе исходные сведения задачи, вопрос и все пять гипотез с анонимными идентификаторами; название статьи, эталон, баллы судей и ответы других моделей скрывали. В этом сравнении Astra была и генератором, и прогнозирующей моделью. Для тех же 250 гипотез подробную инструкцию получили также Opus, Claude Haiku 5.5 и Claude Opus 4.8.
Подробная инструкция перечисляла научные критерии: конкретность причинного утверждения, согласие с установленными биологическими данными, проверяемость, соответствие указанной биологической системе и число дополнительных допущений. Для каждой гипотезы требовались два самостоятельных ответа: субъективная вероятность экспериментального подтверждения от 0 до 1 (или указание на недостаток данных) и рекомендация провести экспериментальную проверку («да» или «нет»). Рекомендацию брали из ответа модели и из вероятности не вычисляли. Модель также обосновывала решение, перечисляла допущения и противоречия и предлагала вмешательство, измеряемый показатель и контрольные условия эксперимента.
Короткий вопрос («Для каждой из приведённых ниже гипотез: будет ли она подтверждена экспериментально?») требовал только прогноза «да» или «нет». В обоих вариантах ответ возвращали в формате JSON; тексты запросов приведены в приложении Б. Подробная инструкция требовала рекомендации провести эксперимент, короткий вопрос — прогноза его результата, и это различие учитывали при интерпретации.
Ответ на задачу считали пригодным, если он содержал решения по всем пяти гипотезам в требуемом формате. Если в одном из вариантов пригодного ответа не было, все гипотезы задачи исключали из обоих вариантов; технические пропуски учитывали отдельно от ответов «нет». В парное сравнение вошли 245 гипотез по 49 задачам для Sonnet, по 250 гипотез по 50 задачам для Astra и Gemini и 225 гипотез по 45 задачам для Grok.
2.6. Набор из 50 подтверждённых и 50 опровергнутых утверждений
Набор с известными исходами обеих групп (далее набор 50/50) составили по 50 другим статьям по биологии старения и смежным областям экспериментальной биологии, впервые опубликованным с 1 июля по 5 октября 2026 года. Пересечения с набором генерации исключили по идентификаторам PubMed. Ранние версии каждой статьи искали теми же шестью способами относительно общей границы 30 июня 2026 года; записи поиска сохранены. Ещё 15 статей-кандидатов исключили до составления утверждений, поскольку проверку препринтов для них завершить не удалось.
ИИ-ассистент Codex по полным текстам разделов результатов и подписям к рисункам каждой статьи сформулировал и проверил два утверждения о действии экспериментального вмешательства. Подтверждённое утверждение согласовывалось с измеренным результатом, опровергнутое прямо ему противоречило. В 49 опровергнутых утверждениях предсказанное направление изменения показателя было противоположно измеренному. В одном утверждении предполагалось, что вмешательство сохранит мышечные стволовые клетки после повреждения мышцы, тогда как в эксперименте их пул оказался истощённым. Для каждого утверждения сохранены результат, на основании которого присвоена метка, цитата из статьи и ссылка на рисунок или абзац.
Опровергнутые утверждения составлены по уже известным результатам, и их формулировки могут отличаться от гипотез, которые исследователи считали перспективными до эксперимента. При обращении направления эффекта модель может опираться на общее знание о благоприятном действии вмешательства. Поэтому результаты на этом наборе характеризуют различение исходов в ретроспективных условиях.
Прогнозы получили от Sonnet, Astra, Gemini, Grok и Opus. Каждый запрос содержал одно утверждение и вопрос «Будет ли эта гипотеза подтверждена экспериментально?»; объяснение и численную вероятность не запрашивали. Ответы на другие утверждения, название и текст статьи, библиографические идентификаторы, результаты эксперимента и метки в запрос не включали, соотношение групп моделям не сообщали. Два утверждения одной статьи могли получить одинаковые ответы: в отличие от BrainBench 10, соотношение 50/50 описывает состав набора и выбора внутри пары не задаёт. Для каждой из пяти моделей получено 100 пригодных прогнозов.
2.7. Случайный контроль и правила согласия
Для каждой гипотезы программа один раз выбирала ответ «да» или «нет» с вероятностью 0,5 (функции crypto.randomInt и crypto.randomBytes среды Node.js; приложение М.3). Криптографический генератор работает без начального значения, поэтому сохранены сами ответы с идентификаторами гипотез и временем генерации, и во всех расчётах использована одна и та же последовательность. Если прогноз модели был технически непригоден, соответствующий случайный ответ исключали из парного сравнения. Каждый вычислительный эксперимент сравнивали со своим случайным контролем.
Случайные ответы сохраняют около половины гипотез, а группа моделей оставляет короткий список. Поэтому дополнительно рассчитали распределение числа совпадений в случайном списке той же длины, что у группы моделей, выбранном из всего исходного набора (гипергеометрическое распределение), и в списке, случайно сокращённом из положительных прогнозов каждой отдельной модели (приложения Ж и М.3).
Совместный отбор определяли по числу моделей, ответивших «да»: хотя бы одна, большинство или все. От выбранного правила одновременно зависят число рекомендаций, PPV и чувствительность, поэтому для единогласного отбора всегда указывали чувствительность.
2.8. Двухэтапный отбор
Правило отбора выбрали по сохранённым прогнозам для гипотез, которые Grok сгенерировала одним запросом. На первом этапе исключали гипотезы с ответом «нет» от Astra. На втором сохраняли только гипотезы с ответом «да» всех четырёх моделей: Sonnet, Astra, Gemini и Grok. Прогноз Astra повторно не запрашивали, но учитывали при определении единогласия; Opus в эту группу не входила.
На гипотезах Grok перебрали 80 правил голосования: все пороги числа ответов «да», от одного до единогласия, для каждого из 31 непустого сочетания пяти моделей (Sonnet, Astra, Gemini, Grok и Opus). Дополнительно рассмотрели 32 двухэтапные схемы: Astra или Sonnet на первом этапе в сочетании с каждым из 16 составов группы на втором. Всего 112 вариантов процедуры соответствуют 90 различным логическим правилам; состав перебора описан в приложении М.4, результаты сохранены в отчёте расширенного эксперимента и отчёте двухэтапного отбора. Каждый перечень повторно оценили при двух порогах совпадения и двух способах разбора ответов моделей. Результаты этих оценок зависимы, поскольку правила опираются на общие прогнозы.
По задаче R42725837 не были получены прогнозы Grok, по задаче R42749700 — ответ Gemini из-за превышения времени ожидания. Десять гипотез этих задач исключили из всех сравниваемых вариантов как технические пропуски, и для гипотез Grok анализировали 48 задач и 240 гипотез. Для Gemini и Opus использовали по 50 задач и 250 гипотез.
Правило, выбранное на гипотезах Grok, применили к гипотезам Gemini и Opus, сохранив состав группы и требование единогласия. Для этих гипотез получили новые прогнозы; задачи и баллы судей оставались прежними. Состав наборов и правило зафиксировали до новых запросов к прогнозирующим моделям: 23 октября 2026 года в 21:43 UTC для гипотез Gemini и в 22:09 UTC для гипотез Opus.
Число прогнозов при последовательном выполнении правила рассчитывали отдельно от фактического числа запросов: один прогноз первого этапа для каждой гипотезы и по одному прогнозу от трёх остальных моделей для гипотез, прошедших первый этап.
2.9. Изоляция моделей и совмещение ролей
Эталоны в запросы к генераторам и прогнозирующим моделям не включали, а даты публикаций проверяли, чтобы уменьшить вероятность присутствия результатов в обучающих данных. Во всех вычислительных экспериментах прогнозирования, кроме раннего эксперимента на 2997 гипотезах, отключение интернета и инструментов подтверждено по сохранённым ответам, журналу вызовов и настройкам запросов.
В первоначальных генерациях Astra обнаружили доступ к сети. Из набора изъяли 51 затронутый ответ генерации в режиме Omega Point (17 наборов гипотез и 34 набора идей) и 424 связанных вердикта судей и получили ответы заново.
Для исходных генераций Opus (150 наборов, 747 гипотез, 788 запросов, 13–18 октября) отключение инструментов подтвердить по журналам нельзя: до исправления 21 октября этот параметр терялся при потоковой передаче запроса, а журналы запросов за эти даты не сохранились. При воспроизведении прежней конфигурации все попытки модели обратиться к инструментам были отклонены, а в ответах исходной генерации не найдено ссылок на веб-страницы, DOI, номеров PubMed и упоминаний 2026 года (приложение М.5). Генерацию Opus повторили 27–28 октября по тем же задачам и запросам с подтверждённым для каждого запроса отключением инструментов и оценили теми же судьями. Повторную генерацию рассматривали как анализ чувствительности; основным оставался исходный набор.
В раннем эксперименте на 2997 гипотезах внешние прогнозирующие модели не участвовали в генерации и судейской оценке тех гипотез, для которых давали прогнозы; генератор отдельно прогнозировал собственные гипотезы (приложение Д). В последующих экспериментах Gemini с высоким бюджетом рассуждения прогнозировала подтверждение гипотез, которые Gemini со средним уровнем рассуждения ранее оценивала как судья, а Opus совмещала роли судьи и прогнозирующей модели в расширенном эксперименте на гипотезах Grok. Оценки и прогнозы получали в отдельных запросах. Использование одной базовой модели или моделей одной компании в разных ролях остаётся источником зависимости.
2.10. Статистический анализ
Для каждой гипотезы сопоставляли бинарный исход и бинарный прогноз. Исходом в наборе генерации служило совпадение с эталоном, в наборе 50/50 — экспериментальное подтверждение. Рассчитывали прогностическую ценность положительного результата (PPV), прогностическую ценность отрицательного результата (NPV), чувствительность и специфичность; в наборе генерации ложноотрицательным считали отрицательный прогноз для гипотезы, совпадающей с эталоном. Долю совпадений в каждом режиме генерации рассчитывали по 250 гипотезам.
Доверительные интервалы рассчитывали кластерным бутстрепом по 10 000 повторных выборок с процентильными границами 2,5 и 97,5 %. Единицей повторной выборки служила задача со всеми её гипотезами, баллами и прогнозами, в наборе 50/50 — статья с обоими утверждениями. В анализе двухэтапного отбора исходный набор, оба этапа, итоговый список и случайный контроль пересчитывали совместно в каждой повторной выборке, при обоих порогах на одних и тех же выборках. Если знаменатель в повторной выборке равнялся нулю, значение считали отсутствующим. Начальные значения генератора случайных чисел приведены в приложении М.6. Диапазоны для случайных списков одинаковой длины отражают случайность выбора списка при фиксированном наборе и доверительными интервалами не являются.
Способы генерации сравнивали перестановкой меток режимов у целых пар ответов внутри задачи; статистикой служила разность долей совпадений. Если перестановка меняла результат не более чем в 16 парах, использовали полный перебор, иначе 19 999 случайных перестановок с добавлением единицы в числитель и знаменатель 7. Процедура предполагает обменимость меток при нулевой гипотезе и причинного эффекта не устанавливает. К 12 внутримодельным сравнениям (три пары способов генерации для каждой из четырёх моделей) применяли поправку Холма 8; анализ разведочный. Доверительные интервалы отдельных разностей рассчитаны без поправки, поэтому значимость определяли по скорректированному p. При 19 999 перестановках и поправке на 12 сравнений наименьшее достижимое значение равно 0,0006, поэтому порог строже 0,001 не используется. Для оригинальности сохранили поправку Холма на полное семейство из 150 сравнений исходного анализа LiveIdeaBench (приложение М.6).
Интервалы в сравнении двух вариантов запроса и на наборе 50/50 рассчитаны по 10 000 повторных выборок задач или статей и приведены как описательные, без поправки на рассмотрение всех правил согласия.
Степень подсказки в каждом из 50 вопросов оценили по шкале 0–2: 0 — назван только исследуемый феномен; 1 — указан класс объяснений, источник воздействия или общий процесс; 2 — задана существенная часть эталона, например вмешательство с направлением эффекта или ключевые молекулярные участники. Разметку выполнил один ИИ-ассистент по текстам заданий и эталонам после получения исходного корпуса гипотез. Шкалу, оценки и план анализа зафиксировали до сопоставления с результатами генерации по отдельным задачам; сводные результаты и примеры об АМФ-активируемой протеинкиназе (AMPK) и о гибели двигательных нейронов ассистенту были известны. Основным анализом служила корреляция Спирмена между оценкой подсказки и долей совпадений при генерации одним запросом, усреднённой по четырём генераторам, по 50 задачам при обоих порогах; p рассчитывали по 99 999 перестановкам оценок между задачами, к двум проверкам применили поправку Холма. Дополнительные проверки имели разведочный характер (приложение М.6).
Сравнение с лучшей одиночной моделью при одинаковой длине списка, ранжирование по численной вероятности подтверждения, отбор без прогнозирующей модели компании генератора, решения внутри пар набора 50/50, лексическая проверка ключевых элементов, сравнение оригинальности отобранных и исключённых гипотез и повторный запуск прогнозов описаны в приложении М.6. Для двух последних проверок 30 октября получили новые ответы моделей, остальные выполнены по сохранённым ответам. Расчёты выполнены на Python с NumPy 2.4.6.
2.11. Отклонения от протокола
Правило учёта отказов Claude приняли 15 октября, во время сбора исходной генерации (13–18 октября), и затем применяли ко всем запускам без изменений. В исходной генерации два итоговых ответа Omega Point содержали три и четыре гипотезы вместо пяти. В первом из них ответ четвёртой ступени, оборванный классификатором, сохранился вместе с повторным ответом модели, и сценарий не разобрал гипотезы этой ступени; ошибку исправили 14 октября. Недостающие гипотезы не дописывали и не оценивали. Случайный контроль для 250 гипотез Astra сгенерирован после просмотра результатов моделей; для набора 50/50 последовательность зафиксирована до получения прогнозов. В протоколе эксперимента 50/50 основным показателем была сбалансированная точность (приложение З); разбор PPV и NPV, решения внутри пар и сопоставление с BrainBench добавлены после получения результатов. Анализ степени подсказки выполнен после получения исходного корпуса гипотез.
Врезка 1. Пример задачи R42744804
Задача составлена по статье Huang и соавт. о гибели двигательных нейронов у трансгенных мышей SOD1G93A, модели бокового амиотрофического склероза 6. Исходные сведения описывали потерю двигательных нейронов, денервацию мышц и преждевременную гибель животных и указывали на возможное участие взаимодействий нейронов с окружающими клетками. Вопрос: «Какой связанный с заболеванием механизм вызывает гибель двигательных нейронов и ускоряет смерть мышей SOD1G93A?»
По эталону микроглия через рецепторы Axl и MerTK распознаёт фосфатидилсерин на поверхности ещё живых нейронов и поглощает их; инактивация генов этих рецепторов сохраняла двигательные нейроны и нервно-мышечные синапсы и продлевала жизнь мышей. Микроглия, рецепторы и поглощение живых клеток в исходных сведениях и вопросе не названы.
В ответ на один запрос Gemini предложила пять гипотез. Вторая из них описывала поглощение испытывающих стресс, но ещё живых двигательных нейронов микроглией и макрофагами с участием фосфатидилсерина, рецептора MerTK и компонентов комплемента; Axl не назван. GPT-5.6 Sol, Claude Opus 5.5 и Grok 4.7 поставили ей 3, 4 и 4 балла, и гипотеза совпала с эталоном при обоих порогах. Остальные четыре гипотезы получили от каждого судьи менее 3 баллов.
Все четыре прогнозирующие модели дали совпавшей гипотезе прогноз «нет», и первый этап её исключил. Astra дала прогноз «да» только гипотезе о гибели нейронов под действием цитотоксических Т-лимфоцитов и естественных киллеров (баллы судей 1, 1 и 2); единогласия эта гипотеза не получила, и итоговый список по задаче оказался пустым. Пример выбран потому, что ответ требует конкретного механизма гибели нейронов; степень подсказки в остальных заданиях он не характеризует. Решения по всем пяти гипотезам приведены в приложении А.
3. Результаты§
3.1. Совпадение сгенерированных гипотез с эталоном
При генерации одним запросом с эталоном совпадали 13,2–18,0 % гипотез четырёх моделей, при многоступенчатой схеме 11,2–18,8 %, при Omega Point 2,8–7,6 % (таблица 1).
Таблица 1. Доля гипотез, совпадающих с эталоном
| Модель-генератор▲ | Один запрос, % (n/250) [95 % ДИ]▲ | Многоступенчатая схема, % (n/250) [95 % ДИ]▲ | Omega Point, % (n/250) [95 % ДИ]▲ |
|---|---|---|---|
| GPT-6 Astra | 14,4 % (36/250) [9,6; 19,6] | 16,0 % (40/250) [10,4; 22,0] | 3,2 % (8/250) [0,8; 6,0] |
| Grok 4.5 | 16,8 % (42/250) [11,6; 22,4] | 18,8 % (47/250) [12,0; 26,4] | 2,8 % (7/250) [0,8; 5,2] |
| Claude Opus 5.5 | 18,0 % (45/250) [13,2; 23,2] | 11,2 % (28/250) [5,2; 18,4] | 4,0 % (10/250) [1,6; 6,8] |
| Gemini 4 Argon | 13,2 % (33/250) [9,6; 17,2] | 17,2 % (43/250) [12,4; 22,4] | 7,6 % (19/250) [4,0; 11,6] |
| Claude Opus 5.5, повторная генерация | 18,0 % (45/250) [12,8; 23,6] | 14,4 % (36/250) [9,2; 20,0] | 1,2 % (3/250) [0,0; 2,8] |
Основной порог: балл не ниже 3 не менее чем от двух из трёх судей других компаний. Недостающие из-за отказа Claude гипотезы засчитаны как несовпадающие. Строка повторной генерации Opus относится к анализу чувствительности (раздел 2.9). ДИ рассчитаны по 10 000 повторных выборок 50 задач.
После поправки Холма многоступенчатая схема не имела статистически значимого преимущества перед одним запросом ни у одной модели, а точечные оценки разности различались по знаку (таблица 2). Доля совпадений при Omega Point была ниже, чем при одном запросе, у всех четырёх моделей (скорректированное p < 0,05).
Таблица 2. Разность долей совпадений между схемой и одним запросом
| Модель▲ | Схема▲ | Разность, п. п. [95 % ДИ]▲ | Задач с большей долей у схемы▲ | Задач с меньшей долей у схемы▲ | Задач с равной долей▲ | p с поправкой Холма▲ |
|---|---|---|---|---|---|---|
| GPT-6 Astra | Многоступенчатая схема | 1,6 [−3,2; 6,4] | 12 | 10 | 28 | 1,000 |
| GPT-6 Astra | Omega Point | −11,2 [−17,2; −6,0] | 3 | 20 | 27 | < 0,01 |
| Grok 4.5 | Многоступенчатая схема | 2,0 [−2,8; 7,2] | 14 | 12 | 24 | 1,000 |
| Grok 4.5 | Omega Point | −14,0 [−19,6; −8,8] | 3 | 26 | 21 | < 0,001 |
| Claude Opus 5.5 | Многоступенчатая схема | −6,8 [−12,0; −1,2] | 6 | 22 | 22 | 0,156 |
| Claude Opus 5.5 | Omega Point | −14,0 [−19,6; −8,8] | 2 | 25 | 23 | < 0,001 |
| Gemini 4 Argon | Многоступенчатая схема | 4,0 [0,4; 7,6] | 12 | 4 | 34 | 0,190 |
| Gemini 4 Argon | Omega Point | −5,6 [−9,2; −2,0] | 4 | 16 | 30 | < 0,05 |
Разность выражена в процентных пунктах (п. п.); положительная разность означает более высокую долю совпадений у схемы. Сумма трёх столбцов с числом задач в каждой строке равна 50. Значения p скорректированы на 12 внутримодельных сравнений, включая четыре сравнения Omega Point с многоступенчатой схемой; ДИ приведены без поправки.
При строгом пороге с эталоном совпадали 1,6–3,6 % гипотез, полученных одним запросом: модели чаще называли механизм, исследованный в статье, чем воспроизводили её центральное причинное утверждение с ключевыми элементами (приложение В).
Повторная генерация Opus с подтверждённым отключением инструментов дала при одном запросе ту же долю совпадений, 18,0 % (45/250; парная разность 0,0 п. п. [−4,4; 4,4]). При многоступенчатой схеме доля составила 14,4 % против 11,2 % в исходной генерации (разность 3,2 п. п. [−2,4; 8,8]; p = 0,688 с поправкой Холма на три сравнения), при Omega Point 1,2 % против 4,0 % (−2,8 п. п. [−5,2; −0,4]; p = 0,188; при восьми различающихся задачах разрешающая способность перестановочного теста низкая). В повторной генерации доля совпадений при Omega Point также была ниже, чем при одном запросе (−16,8 п. п. [−22,0; −12,0]; p < 0,001). Различие сохранялось после исключения всех наборов, в которых хотя бы одна ступень содержала отказ Claude или оборванный ответ: −16,5 п. п. в исходной и −17,8 п. п. в повторной генерации (p < 0,001). Без исходных генераций Opus доля совпадений при Omega Point была ниже, чем при одном запросе, у каждой из трёх остальных моделей (p < 0,05 с поправкой Холма на девять сравнений). Отказы Claude и пересчёты приведены в приложении Н.1.
Из 50 вопросов оценку подсказки 0 получили 8, оценку 1 — 30, оценку 2 — 12. При генерации одним запросом в группе с оценкой 2 с эталоном совпадали 25,8 % гипотез (62/240; 95 % ДИ [14,7; 36,8]), в двух остальных группах 12,4 % (94/760); разность 13,5 п. п. (нескорректированный 95 % ДИ [2,1; 25,0]). Коэффициент Спирмена между оценкой подсказки и долей совпадений составил ρ = 0,17 при основном пороге (95 % ДИ [−0,15; 0,46]) и ρ = 0,17 при строгом (95 % ДИ [−0,16; 0,48]); p = 0,434 в обоих случаях после поправки Холма. На 38 заданиях с оценкой 0 или 1 доля совпадений при одном запросе была ниже, чем на всех 50 заданиях, у каждой из четырёх моделей (приложение Н.2). Эти результаты согласуются с вкладом подсказки в совпадение с эталоном и не определяют ни величину связи, ни причинный эффект.
Отношение числа сгенерированных токенов многоступенчатой схемы к расходу Omega Point составило 0,978 у Astra, 1,080 у Grok, 1,059 у Opus и 1,119 у Gemini. Один запрос у всех четырёх моделей расходовал меньше токенов, чем каждая из схем (данные о токенах).
3.2. Оригинальность исследовательских идей
По оценкам одних и тех же судей других компаний идеи Omega Point получали более высокие баллы оригинальности, чем идеи, сгенерированные одним запросом. После поправки Холма на семейство из 150 сравнений различие сохранялось у Astra, Grok и Gemini (p < 0,01); у Opus скорректированное p составило 0,205 (таблица 3). Оригинальность оценивали на отдельном наборе ключевых слов, и к совпадению гипотез с эталоном этот результат не относится.
Таблица 3. Оригинальность идей Omega Point и одного запроса
| Модель▲ | Ключевых слов в сравнении▲ | Разность баллов, Omega Point минус один запрос [95 % ДИ]▲ | Слов с более высоким баллом у Omega Point▲ | Слов с более низким баллом у Omega Point▲ | Слов с равным баллом▲ | p с поправкой Холма▲ |
|---|---|---|---|---|---|---|
| GPT-6 Astra | 89 | 0,39 [0,24; 0,55] | 53 | 19 | 17 | < 0,01 |
| Grok 4.5 | 100 | 0,69 [0,49; 0,89] | 69 | 21 | 10 | < 0,01 |
| Claude Opus 5.5 | 100 | 0,28 [0,07; 0,46] | 61 | 30 | 9 | 0,205 |
| Gemini 4 Argon | 98 | 0,37 [0,24; 0,49] | 59 | 19 | 20 | < 0,01 |
Шкала 1–10. В сравнение вошли ключевые слова с пригодными оценками обоих способов генерации; единица повторной выборки — ключевое слово. Поправка Холма на 150 сравнений (состав семейства в приложении М.6).
3.3. Подробная инструкция и короткий вопрос
Из 250 гипотез Astra с эталоном совпадали 36. По подробной инструкции Astra рекомендовала проверить 200 гипотез, из них с эталоном совпадали 16,0 % (32/200); чувствительность рекомендации составила 88,9 % (32/36). При коротком вопросе Astra дала 75 прогнозов «да», из них совпадали 30,7 % (23/75), чувствительность 63,9 % (23/36). Разность PPV составила 14,7 п. п. (95 % ДИ [7,8; 22,0]).
У всех четырёх моделей точечная оценка PPV при коротком вопросе была выше; у Astra и Gemini интервал разности лежит выше нуля, у Sonnet и Grok включает ноль (таблица 4). В сравнении одновременно менялись содержание инструкции и формат требуемого решения, поэтому результат относится к двум вариантам запроса в целом.
Таблица 4. PPV двух вариантов запроса на общих гипотезах
| Прогнозирующая модель▲ | Общих гипотез▲ | Подробная инструкция, PPV, % (n/N) [95 % ДИ]▲ | Короткий вопрос, PPV, % (n/N) [95 % ДИ]▲ | Разность PPV, п. п. [95 % ДИ]▲ |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 245 | 20,6 % (26/126) [13,2; 28,9] | 28,6 % (14/49) [16,7; 40,9] | 7,9 [−0,1; 16,2] |
| GPT-6 Astra | 250 | 16,0 % (32/200) [10,1; 22,6] | 30,7 % (23/75) [20,0; 41,8] | 14,7 [7,8; 22,0] |
| Gemini 4 Argon | 250 | 21,1 % (32/152) [13,4; 29,6] | 33,3 % (21/63) [21,8; 45,6] | 12,3 [4,5; 20,8] |
| Grok 4.5 | 225 | 19,7 % (27/137) [12,2; 27,9] | 23,5 % (20/85) [14,1; 34,0] | 3,8 [−1,2; 9,2] |
PPV подробной инструкции относится к рекомендации проверить гипотезу, PPV короткого вопроса — к прогнозу экспериментального подтверждения. Включены гипотезы с пригодным ответом в обоих вариантах; n — число совпадающих гипотез, N — число положительных решений. Разность рассчитана по парным повторным выборкам задач, интервалы описательные. На полном наборе короткого вопроса Grok дала 94 прогноза «да», из них 25 для совпадающих гипотез (26,6 %).
Среди 50 гипотез, которые Astra не рекомендовала проверять, не совпадали с эталоном 92,0 % (46/50); среди гипотез с прогнозом «нет» при коротком вопросе — 92,6 % (162/175). У случайного контроля на тех же 250 гипотезах PPV составила 14,5 % (17/117), NPV 85,7 % (114/133). Все показатели приведены в приложении Г.
Вероятность подтверждения, которую требовала подробная инструкция, позволяет ранжировать гипотезы; AUC этой вероятности на тех же гипотезах составила 0,62–0,74 у семи прогнозирующих моделей. Двухэтапное правило, применённое к ответам четырёх моделей на короткий вопрос для 245 гипотез с ответами всех четырёх, отобрало 22 гипотезы; с эталоном совпадали 50,0 % из них (11/22; 95 % ДИ [30,0; 70,4]) при исходной доле 14,7 % (36/245). Среди 22 гипотез с наибольшей вероятностью подтверждения по оценке каждой модели совпадали 27,3–38,6 %. Разность в пользу двухэтапного правила составила 11,4–22,7 п. п.; p = 0,30–0,66 после поправки Холма на семь моделей (приложение Л.1).
3.4. Прогнозы для подтверждённых и опровергнутых утверждений
На наборе 50/50 среди утверждений с ответом «нет» доля опровергнутых составила 73,6–79,5 % у отдельных моделей и 52,1 % (25/48) у случайного контроля; PPV пяти моделей составила 67,2–80,4 % (таблица 5). Сбалансированная точность моделей составила 71,0–78,0 %, случайного контроля 52,0 % (приложение З). В этом наборе отрицательный исход означает прямое экспериментальное опровержение, в наборе генерации — несовпадение с эталоном.
Таблица 5. Прогнозы отдельных моделей на наборе 50/50
| Прогнозирующая модель▲ | PPV, % (n/N) [95 % ДИ]▲ | NPV, % (n/N) [95 % ДИ]▲ | Чувствительность▲ | Специфичность▲ |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 72,2 % (39/54) [64,0; 81,5] | 76,1 % (35/46) [66,7; 86,0] | 78,0 % (39/50) | 70,0 % (35/50) |
| GPT-6 Astra | 67,2 % (41/61) [60,3; 75,5] | 76,9 % (30/39) [66,7; 87,9] | 82,0 % (41/50) | 60,0 % (30/50) |
| Gemini 4 Argon | 80,4 % (37/46) [70,6; 90,5] | 75,9 % (41/54) [67,2; 85,4] | 74,0 % (37/50) | 82,0 % (41/50) |
| Grok 4.5 | 76,6 % (36/47) [66,0; 87,2] | 73,6 % (39/53) [64,0; 83,7] | 72,0 % (36/50) | 78,0 % (39/50) |
| Claude Opus 5.5 | 68,9 % (42/61) [62,0; 76,9] | 79,5 % (31/39) [70,0; 90,3] | 84,0 % (42/50) | 62,0 % (31/50) |
| Случайный контроль | 51,9 % (27/52) [42,9; 61,1] | 52,1 % (25/48) [42,2; 62,2] | 54,0 % (27/50) | 50,0 % (25/50) |
Набор содержит 100 утверждений из 50 статей, по 50 подтверждённых и опровергнутых. ДИ рассчитаны по повторным выборкам статей; интервалы чувствительности и специфичности приведены в структурированном отчёте.
Единогласный прогноз «да» пяти моделей получили 26 утверждений, из них экспериментально подтверждены 88,5 % (23/26; 95 % ДИ [76,7; 100,0]); у случайного контроля эта доля составила 51,9 % (27/52; 95 % ДИ [42,9; 61,1]). Чувствительность единогласия составила 46,0 % (23/50; 95 % ДИ [32,0; 60,0]), остальные 27 подтверждённых утверждений в список не вошли. При чувствительности 46,0 %, специфичности 94,0 % и доле положительных исходов 13,2 и 18,0 %, наблюдавшейся при генерации одним запросом, PPV составила бы 53,8 и 62,7 % (раздел 4.3). Результаты других сочетаний моделей приведены в опубликованном отчёте.
Внутри пар модели приняли подтверждённое утверждение и отвергли опровергнутое в 46,0–62,0 % из 50 пар, случайный контроль в 24,0 % (12/50); обратное решение модели вынесли в 1–5 парах, случайный контроль в 10. Детерминированное правило «эффект в благоприятную сторону» разметило 61 утверждение из 100 и совпало с экспериментальным исходом в 65,6 % размеченных случаев (40/61); модели на тех же утверждениях ответили верно в 68,9–77,0 % случаев. В 20 парах, где правило разметило оба утверждения, оно верно разделило 5 пар, модели 8–13, случайный контроль 5 (приложения Л.4 и Н.8).
3.5. Согласие прогнозирующих моделей на всём корпусе
В раннем эксперименте на всех 2997 гипотезах, полученных тремя способами генерации, среди гипотез с прогнозом «да» самого генератора с эталоном совпадали 26,8 % (164/611). При прогнозе «да» большинства прогнозирующих моделей совпадали 37,8 % (123/325), при единогласии 50,0 % (55/110); у случайного контроля 12,1 % (179/1477). Интервалы и чувствительность приведены в приложении Д. Инструкцию для прогнозирующих моделей разработали на этом же корпусе, поэтому результат описывает связь согласия с совпадением в его пределах.
3.6. Двухэтапный отбор
На 240 гипотезах Grok первый этап оставил 53 гипотезы, из них 25 совпадающих; после требования единогласия осталось 19, из них 14 совпадающих. PPV итогового списка составила 73,7 % (14/19; 95 % ДИ [52,6; 93,3]) против 17,9 % (22/123) у случайного контроля, чувствительность 35,0 % (14/40; 95 % ДИ [25,0; 46,2]). Первый этап исключил 15 из 40 совпадающих гипотез, второй ещё 11 (таблицы 6 и 7).
На гипотезах Gemini первый этап оставил 51 гипотезу, второй 19, из них 9 совпадающих: PPV 47,4 % (95 % ДИ [25,0; 70,6]), чувствительность 27,3 % (9/33; 95 % ДИ [13,6; 42,9]). На гипотезах Opus осталось 49 и 22 гипотезы, из них 14 совпадающих: PPV 63,6 % (95 % ДИ [42,9; 82,4]), чувствительность 31,1 % (14/45; 95 % ДИ [18,4; 43,9]). На 245 гипотезах повторной генерации Opus, из которых 43 совпадали с эталоном, итоговый список содержал 17 гипотез, из них 10 совпадающих: PPV 58,8 % (95 % ДИ [35,0; 81,8]) против 18,8 % у случайного контроля (разность 40,0 п. п. [16,5; 62,6]), чувствительность 23,3 % (95 % ДИ [12,5; 34,7]).
Таблица 6. Размер списка и доля совпадений на этапах отбора
| Генератор▲ | Этап▲ | Осталось гипотез▲ | Доля совпадений среди оставшихся, % (n/N) [95 % ДИ]▲ | Доля сохранённых совпадающих гипотез, % (n/N) [95 % ДИ]▲ | Исключено совпадающих гипотез на этапе▲ |
|---|---|---|---|---|---|
| Grok 4.5 | До отбора | 240 | 16,7 % (40/240) [11,2; 22,5] | 100,0 % (40/40) | — |
| Grok 4.5 | После ответа «да» GPT-6 Astra | 53 | 47,2 % (25/53) [31,4; 63,3] | 62,5 % (25/40) [47,1; 78,8] | 15 из 40 исходных (37,5 %) |
| Grok 4.5 | После единогласия четырёх моделей | 19 | 73,7 % (14/19) [52,6; 93,3] | 35,0 % (14/40) [25,0; 46,2] | 11 из 40 исходных (27,5 %) |
| Gemini 4 Argon | До отбора | 250 | 13,2 % (33/250) [9,6; 17,2] | 100,0 % (33/33) | — |
| Gemini 4 Argon | После ответа «да» GPT-6 Astra | 51 | 27,5 % (14/51) [15,3; 42,0] | 42,4 % (14/33) [27,3; 58,8] | 19 из 33 исходных (57,6 %) |
| Gemini 4 Argon | После единогласия четырёх моделей | 19 | 47,4 % (9/19) [25,0; 70,6] | 27,3 % (9/33) [13,6; 42,9] | 5 из 33 исходных (15,2 %) |
| Claude Opus 5.5 | До отбора | 250 | 18,0 % (45/250) [13,2; 23,2] | 100,0 % (45/45) | — |
| Claude Opus 5.5 | После ответа «да» GPT-6 Astra | 49 | 42,9 % (21/49) [27,8; 58,3] | 46,7 % (21/45) [33,3; 60,0] | 24 из 45 исходных (53,3 %) |
| Claude Opus 5.5 | После единогласия четырёх моделей | 22 | 63,6 % (14/22) [42,9; 82,4] | 31,1 % (14/45) [18,4; 43,9] | 7 из 45 исходных (15,6 %) |
Исходные гипотезы получены одним запросом. Второй этап — единогласие четырёх моделей. ДИ рассчитаны по 10 000 совместных повторных выборок целых задач для всех этапов. В последнем столбце указана доля от исходного числа совпадающих гипотез; потери двух этапов можно складывать.
Таблица 7. Двухэтапный отбор и случайный контроль на тех же гипотезах
| Генератор и правило▲ | PPV, % (n/N) [95 % ДИ]▲ | NPV, % (n/N)▲ | Чувствительность, % (n/N) [95 % ДИ]▲ | Специфичность, % (n/N)▲ |
|---|---|---|---|---|
| Grok 4.5; двухэтапный отбор | 73,7 % (14/19) [52,6; 93,3] | 88,2 % (195/221) | 35,0 % (14/40) [25,0; 46,2] | 97,5 % (195/200) |
| Grok 4.5; случайный контроль | 17,9 % (22/123) [10,2; 26,4] | 84,6 % (99/117) | 55,0 % (22/40) [40,0; 69,2] | 49,5 % (99/200) |
| Gemini 4 Argon; двухэтапный отбор | 47,4 % (9/19) [25,0; 70,6] | 89,6 % (207/231) | 27,3 % (9/33) [13,6; 42,9] | 95,4 % (207/217) |
| Gemini 4 Argon; случайный контроль | 12,1 % (16/132) [7,0; 17,7] | 85,6 % (101/118) | 48,5 % (16/33) [30,6; 66,7] | 46,5 % (101/217) |
| Claude Opus 5.5; двухэтапный отбор | 63,6 % (14/22) [42,9; 82,4] | 86,4 % (197/228) | 31,1 % (14/45) [18,4; 43,9] | 96,1 % (197/205) |
| Claude Opus 5.5; случайный контроль | 16,8 % (20/119) [9,7; 24,6] | 80,9 % (106/131) | 44,4 % (20/45) [28,9; 58,8] | 51,7 % (106/205) |
| Claude Opus 5.5, повторная генерация; двухэтапный отбор | 58,8 % (10/17) [35,0; 81,8] | 85,5 % (195/228) | 23,3 % (10/43) [12,5; 34,7] | 96,5 % (195/202) |
| Claude Opus 5.5, повторная генерация; случайный контроль | 18,8 % (25/133) [11,7; 26,8] | 83,9 % (94/112) | 58,1 % (25/43) [44,1; 71,1] | 46,5 % (94/202) |
Наборы: Grok — 240 гипотез, из них 40 совпадающих; Gemini — 250 и 33; Opus — 250 и 45; повторная генерация Opus — 245 и 43 (пять гипотез одной задачи исключены как технический пропуск Grok). ДИ рассчитаны по парным повторным выборкам задач; полные интервалы в приложении Е.
Во всех наборах доля совпадений после отбора превышала долю у случайного контроля. Интервалы при этом широкие, а точечные оценки различаются, поэтому значение 73,7 %, полученное на гипотезах Grok, нельзя считать установленным для других генераторов. На 48 задачах, общих для трёх генераторов, 95 % ДИ всех попарных разностей между генераторами включали ноль как для доли совпадений, так и для чувствительности (приложение Н.3).
Astra входит в группу, поэтому гипотеза с её ответом «нет» единогласия не получит, и первый этап не меняет итоговый список. При последовательном опросе требуется 397–403 прогноза отдельных моделей вместо 960–1000 при опросе всех четырёх моделей для каждой гипотезы (приложение Н.4).
3.7. Сравнение со случайным списком и с лучшей одиночной моделью
Случайный список той же длины из всего исходного набора содержал бы в среднем 3,17 совпадающей гипотезы из 19 у Grok (центральный 95 % диапазон 0–6), 2,51 из 19 у Gemini (0–6) и 3,96 из 22 у Opus (1–8). Группа моделей отобрала 14, 9 и 14 совпадающих гипотез, что во всех трёх наборах выше верхней границы диапазона (приложение Н.6). Эта проверка показывает обогащение списка относительно исходного набора.
Вклад группы по сравнению с одной моделью оценили при одинаковой длине списка. На гипотезах Grok доля совпадений в списке группы составила 73,7 % против 47,2 % (25/53) у лучшей одиночной модели Astra (разность 26,5 п. п. [8,2; 45,9]; p < 0,05 с поправкой Холма на четыре набора). На гипотезах Opus доля составила 63,6 % против 42,9 % (21/49) у Astra (20,8 п. п. [6,8; 35,6]; p < 0,05), на гипотезах повторной генерации Opus 58,8 % против 34,4 % (21/61) у Gemini (24,4 п. п. [6,0; 44,7]; p < 0,01). На гипотезах Gemini доля составила 47,4 % против 34,0 % (18/53) у самой Gemini (13,4 п. п. [−4,3; 31,5]; p = 0,083): преимущество группы не подтверждено. Оба правила опираются на одни прогнозы, а правило выбрано на гипотезах Grok, поэтому эти значения описывают уже выбранное правило на тех же данных (приложения Ж и Л.2).
3.8. Строгий порог совпадения
При строгом пороге среди отобранных совпадали с эталоном 26,3 % (5/19) гипотез Grok, 31,6 % (6/19) Gemini и 9,1 % (2/22) Opus. Отношение к исходной доле при том же пороге составило 9,02 (95 % ДИ [4,21; 16,00]; исходная доля 2,9 %, 7/240) для Grok, 8,77 ([5,18; 14,71]; 3,6 %, 9/250) для Gemini и 4,55 ([0,00; 11,03]; 2,0 %, 5/250) для Opus; чувствительность составила 71,4 % (5/7), 66,7 % (6/9) и 40,0 % (2/5). Число совпадений при строгом пороге не превышает шести, интервалы широкие, и смена порога меняет как величину долей, так и порядок точечных оценок генераторов (приложения Л.5 и Н.5).
3.9. Проверки устойчивости
На 38 заданиях с оценкой подсказки 0 или 1 доля совпадений среди отобранных составила 63,6 % (7/11) для Grok, 35,7 % (5/14) для Gemini, 62,5 % (10/16) для Opus и 54,5 % (6/11) для повторной генерации Opus. Отношение к исходной доле на тех же заданиях составило 5,0; 3,2; 4,2 и 4,2, нижние границы его 95 % ДИ 3,0; 1,1; 2,6 и 2,1.
При поочерёдном исключении каждого судьи доля совпадений среди отобранных составила 68,4–73,7 % для Grok, 47,4 % для Gemini, 54,5–59,1 % для Opus и 52,9–58,8 % для повторной генерации Opus; нижние границы 95 % ДИ отношения к исходной доле не ниже 2,0.
Без прогнозирующей модели компании генератора единогласие трёх оставшихся моделей давало более длинные списки и меньшую долю совпадений: 68,2 % (15/22) для Grok, 45,0 % (9/20) для Gemini, 53,6 % (15/28) для Opus и 46,4 % (13/28) для повторной генерации Opus. Если бы прогнозирующая модель предпочитала гипотезы своей компании, её исключение повышало бы долю совпадений; во всех четырёх наборах доля снизилась (приложение Л.3).
При повторном запуске тех же запросов решения отдельных моделей совпали в 88,3–96,2 % случаев (каппа Коэна 0,71–0,89); из 58 гипотез, отобранных в исходном запуске, 48 были отобраны повторно. Доля совпадений среди отобранных при повторе составила 68,4 % (13/19) для Grok, 50,0 % (9/18) для Gemini и 66,7 % (14/21) для Opus против 72,2 % (13/18), 47,4 % (9/19) и 61,9 % (13/21) в исходном запуске на тех же гипотезах (приложение Л.7).
Средний балл оригинальности 59 отобранных гипотез был ниже балла исключённых гипотез тех же задач: разность −0,21 (95 % ДИ [−0,47; 0,04]; p = 0,118 с поправкой Холма на три показателя). Осуществимость отобранных гипотез была выше на 0,45 балла ([0,17; 0,73]; p < 0,01), ясность на 0,38 балла ([0,24; 0,53]; p < 0,001). Шансы совпадения с эталоном у отобранных гипотез были выше, чем у исключённых, в 4,72 раза (95 % ДИ [2,36; 9,42]), с поправкой на средний балл ясности в 3,85 раза ([1,81; 8,20]; p < 0,001) (приложение Л.6).
Хотя бы один ключевой элемент эталона назван по лексическому критерию (не менее двух третей его содержательных слов в тексте гипотезы) у 46,2 % (72/156) совпадающих и у 16,4 % (138/844) несовпадающих гипотез из 1000, полученных одним запросом (отношение шансов 4,39 [2,87; 6,81]); AUC доли названных элементов относительно решения судей составила 0,65 ([0,60; 0,70]) (приложение Л.8).
4. Обсуждение§
4.1. Генерация гипотез и точность их отбора
Большинство гипотез, сгенерированных одним запросом, расходилось с результатом выбранной статьи, а исход их экспериментальной проверки неизвестен. Поэтому частота совпадений при генерации ещё не определяет, какие гипотезы следует проверять в первую очередь.
Отбор по прогнозам моделей давал короткие списки с более высокой долей совпадений, но в списки вошли только 27,3–35,0 % всех совпадающих гипотез. При строгом пороге доля совпадений среди отобранных составляла 9,1–31,6 %. Очерёдность будущих экспериментов зависит также от новизны гипотезы, стоимости и осуществимости её проверки и ожидаемой научной информативности.
4.2. Экспериментальное подтверждение и совпадение с эталоном
Прогнозирующим моделям задавали вопрос об экспериментальном подтверждении гипотезы, а их ответы проверяли по совпадению с одним опубликованным результатом. Статья может исследовать один механизм, тогда как предложенная гипотеза описывает другой, ещё не проверенный. Поэтому расхождение со статьёй само по себе гипотезу не опровергает. Оценка судей также не заменяет независимого воспроизведения результата статьи. Схема Omega Point предназначена для поиска нестандартных объяснений, и среди её гипотез, расходящихся со статьёй, могут быть как ошибки, так и правдоподобные альтернативы.
На наборе 50/50 исходы известны для обеих групп, и единогласие пяти моделей дало PPV 88,5 % при чувствительности 46,0 %. Утверждения при этом составлены по завершённым исследованиям, а соотношение групп задано искусственно; для оценки прогнозов будущих экспериментов необходима проспективная проверка.
В BrainBench удаление контекста ухудшало результат, и авторы связывали успешный выбор с объединением сведений о методах и результатах 10. В нашем наборе модель получала только утверждение, без методов и исходных сведений. Правило «эффект в благоприятную сторону» не размечает молекулярные показатели без общепринятого знака. Различение исходов не сводится полностью к знаку ожидаемого эффекта: в 20 парах, где правило разметило оба утверждения, оно верно разделило 5 пар, как и случайный контроль, а модели 8–13.
4.3. Прогностическая ценность и доля положительных исходов
PPV зависит от доли положительных исходов π в выборке. При чувствительности Se и специфичности Sp эта зависимость выражается формулой PPV = Se × π / [Se × π + (1 − Sp) × (1 − π)]. Поэтому значения, полученные на сбалансированном наборе, нельзя непосредственно переносить на наборы сгенерированных гипотез, в которых совпадения с эталоном редки.
По той же причине высокая NPV в наборе генерации ожидаема. В наборе Astra с эталоном совпадали 36 из 250 гипотез, и модель, отвечающая «нет» на каждую гипотезу, была бы права в 85,6 % случаев (214/250). Поэтому NPV порядка 92 % следует рассматривать вместе с чувствительностью и специфичностью. Отбор с высокой NPV может исключать подходящие гипотезы: первый этап исключил 15 из 40 совпадающих гипотез Grok.
4.4. Подробная инструкция и короткий вопрос
При коротком вопросе PPV была выше у всех четырёх прогнозирующих моделей, хотя у Sonnet и Grok интервал разности включал ноль. Подробная инструкция требовала оценить вероятность подтверждения, обосновать решение, составить план эксперимента и рекомендовать проверку, а рекомендация и вероятность были независимыми полями ответа. Короткий вопрос требовал только бинарного прогноза. Поскольку одновременно менялись содержание запроса и смысл требуемого решения, вклад каждого из этих факторов наши данные не разделяют.
4.5. Согласие моделей и независимость доказательств
Единогласие сокращало список и повышало долю совпадений относительно исходного набора. При одинаковой длине списка преимущество группы перед лучшей одиночной моделью подтвердилось на гипотезах Grok и Opus в обеих генерациях и не подтвердилось на гипотезах Gemini. Модели используют общие источники научной литературы, часть из них принадлежит одной компании, а в отдельных экспериментах одна модель была и судьёй, и прогнозирующей моделью. Panickssery, Bowman и Feng показали, что модели-судьи могут предпочитать собственные ответы 9. Мы исключали из основного анализа судью компании генератора, но остальные зависимости сохранялись, поэтому согласие моделей нельзя рассматривать как совокупность независимых оценок. Кроме того, при смене генератора менялся состав трёх судей, и различия генераторов нельзя полностью отделить от различий судейских групп.
Отобранные гипотезы получили более высокие баллы ясности и осуществимости. Если ясная формулировка повышает и балл судей, и вероятность ответа «да», часть обогащения объясняется ею. С поправкой на средний балл ясности отношение шансов совпадения для отобранных гипотез уменьшилось с 4,72 до 3,85 (95 % ДИ [1,81; 8,20]).
Четыре ответа «да» выражают согласие моделей относительно будущего результата. Полезность такого согласия можно проверить только в экспериментах с ещё неизвестным исходом.
4.6. Дальнейшая работа
Мы проверяли, восстанавливают ли модели опубликованные результаты, разрабатывали процедуру прогнозирования на том же корпусе и применяли зафиксированное правило к новым прогнозам для гипотез двух других генераторов. На всех этих этапах эталонные исходы были уже известны.
Формулировка задания может сообщать часть эталона. Вопрос задачи R42810392 задаёт направление эффекта (продление жизни при прямой активации мишени), хотя сама мишень, AMPK, скрыта. Корпус включал только статьи с экспериментально поддержанным результатом, что может давать преимущество утвердительному пересказу вопроса.
Сохранены 60 отобранных гипотез трёх генераторов с идентификаторами и временем исходных прогнозов. Мы планируем сопоставить их с новыми публикациями и проверить правило отбора на новых исследовательских задачах. Для такой проверки заранее фиксируются исходные сведения, список моделей, правило отбора, критерий экспериментального исхода и срок наблюдения, а также требования к совпадению вмешательства, биологической системы, измеряемого показателя и условий эксперимента с исходной гипотезой и процедура независимой оценки. Каждая гипотеза относится к одному из трёх состояний: проверена и поддержана данными; проверена и противоречит данным; исход неизвестен, в том числе при отсутствии публикации о проверке. Проспективная проверка регистрирует все результаты, включая отрицательные, и наблюдение за публикациями её не заменяет.
5. Ограничения§
- Эталоны составила модель GPT-5.6 Sol по аннотациям 50 рецензированных статей.
- Основной исход определяли модели-судьи. На 2997 гипотезах каппа Коэна для голоса «балл 3 и выше» составляла 0,70–0,77 в шести парах судей, каппа Флейса для трёх судей, определявших исход, 0,72 (95 % ДИ [0,67; 0,77]). Решение большинства по 283 из этих гипотез (9,4 %) изменилось бы при смене одного голоса. Среди 60 гипотез, отобранных группой моделей для трёх генераторов, таких решений 6: у 3 из 37 совпадающих и у 3 из 23 несовпадающих гипотез.
- Инструкции и правила разрабатывали на том же корпусе. Итоговое правило выбрали после перебора 80 правил голосования и 32 двухэтапных схем на гипотезах Grok (90 различных логических правил; раздел 2.8). Доверительные интервалы этот подбор не учитывают, поэтому результат выбранного правила может быть завышен. Проверка на гипотезах Gemini и Opus использовала прежние задачи и баллы судей. Сравнения способов генерации также носили разведочный характер.
- В части экспериментов прогнозирующей моделью и судьёй служила одна базовая модель либо модели одной компании, что ограничивает возможность рассматривать группу моделей как совокупность независимых источников (раздел 3.9).
- Временной контроль основан на заявленных границах обучения моделей и результатах поиска ранних версий статей.
- Для исходных генераций Opus (747 гипотез, 788 запросов) и для ответов Opus и Sonnet в раннем эксперименте на 2997 гипотезах сохранившихся журналов недостаточно, чтобы подтвердить отключение инструментов и интернета. Отсутствие этих сведений само по себе не доказывает, что модель использовала сеть; воспроизведение прежней конфигурации и повторная генерация описаны в разделах 2.9 и 3.1.
- После двухэтапного отбора для каждого генератора остаются 19–22 гипотезы, и интервалы PPV широкие. Исключение технических пропусков ограничивает перенос результатов на все исходные задачи. Преимущество группы перед лучшей одиночной моделью при одинаковой длине списка не подтвердилось на гипотезах Gemini. Список двухэтапного правила сравнивали с ранжированием по вероятности на гипотезах Astra, которая на этом наборе была и генератором, и моделью первого этапа (p = 0,30–0,66 после поправки Холма; раздел 3.3).
- Случайный контроль для 250 гипотез Astra добавили после просмотра результатов моделей; случайные ответы сохранили и повторно не генерировали.
- Набор 50/50 искусственно сбалансирован и составлен ИИ-ассистентом по известным результатам. Из 50 опровергнутых утверждений 49 противоречат измеренному направлению эффекта. Codex и Astra относятся к OpenAI. Формат эксперимента отличается от BrainBench 10, а короткий вопрос требует прогноза подтверждения, тогда как подробная инструкция — рекомендации о проверке. Эти обстоятельства ограничивают перенос результатов на лабораторную практику.
- Число сгенерированных токенов между схемами выровнено приближённо.
- Формулировки вопросов могли подсказывать направление эффекта. Анализ степени подсказки основан на разметке одним ИИ-ассистентом и причинного эффекта не устанавливает (разделы 3.1 и 3.9).
- Доверительные интервалы условны относительно выбранных инструкций, правила, ответов и разметки.
6. Заключение§
На 50 задачах по биологии старения генерация одним запросом давала 13,2–18,0 % гипотез, совпадающих с механизмом, установленным в статье. Многоступенчатая схема преимущества после поправки на множественные сравнения не показала. Сокращённая схема Omega Point без поиска литературы давала меньше совпадений, чем один запрос, и более высокие оценки оригинальности на отдельном наборе идей; у Opus снижение доли совпадений сохранялось и после исключения наборов с отказом Claude.
Двухэтапный отбор группой из четырёх прогнозирующих моделей повышал долю совпадений до 47,4–73,7 % при чувствительности 27,3–35,0 %; при строгом пороге доля составляла 9,1–31,6 %. Преимущество группы перед лучшей одиночной моделью при одинаковой длине списка подтвердилось для гипотез Grok и Opus и не подтвердилось для гипотез Gemini.
Все оценки получены при известных исходах и относятся к зафиксированной выборке статей. Исход экспериментальной проверки гипотез, расходящихся с эталоном, пока неизвестен; мы планируем проследить его по новым публикациям и проверить правило отбора на новых задачах.
Доступность данных и кода§
Результаты опубликованы на странице eternalsearch.net/ru/omega/benchmark. Задания, эталоны и примеры оценок судей доступны на странице задач. Все отобранные гипотезы с полным текстом, эталонами и баллами трёх судей приведены в таблице S. Протоколы, сохранённые запросы, ответы моделей и итоговые списки отбора опубликованы на сайте; адреса приведены в приложении О.
К рукописи приложены исходы гипотез, баллы четырёх судей, результаты расчётов, отчёт дополнительных расчётов и описание данных. Таблицы рукописи сформированы программно из этих данных без обращений к моделям; контрольные суммы исходных файлов приведены вместе с результатами. Сценарии анализа предоставляются по запросу.
Декларации§
Конфликт интересов. Команда Eternal Search, проводившая исследование, и разработчики Omega Point работают в Open Longevity. Авторы исследования не участвовали в разработке Omega Point. Общая организационная принадлежность представляет потенциальный конфликт интересов. Для его контроля Omega Point сравнивали с другими способами генерации по единому правилу совпадения с эталоном, из основного анализа исключали оценки судьи компании, разработавшей генератор, и сохраняли полные ответы моделей, правила отбора и ответы случайного контроля.
Финансирование. [Заполняется автором. Укажите для каждого источника: название организации, страну, номер гранта или договора и роль источника в работе. Если роли не было, пишется: «Источники финансирования не участвовали в планировании исследования, сборе и анализе данных, подготовке рукописи и решении о публикации». Если финансирования не было, пишется: «Исследование выполнено без внешнего финансирования».]
Вклад авторов. [Заполняется автором. По одному предложению на автора в формате «Имя Фамилия: вклад», термины по CRediT: замысел исследования, методология, программное обеспечение, проверка результатов, формальный анализ, исследование, данные, написание первоначального текста, редактирование, визуализация, руководство, привлечение финансирования. Отдельной строкой: «Все авторы прочитали и одобрили окончательный текст».]
Исследования с участием людей и животных. В работе анализируются опубликованные исследования и ответы языковых моделей. Новые лабораторные эксперименты в рамках этого бенчмарка не проводились.
Литература§
- Ruan K, Wang X, Hong J, Wang P, Liu Y, Sun H. Evaluating LLMs' divergent thinking capabilities for scientific idea generation with minimal context. Nature Communications. 2026;17:3625. doi:10.1038/s41467-026-70245-1.
- Yang Z, Liu W, Gao B, Xie T, Li Y, Ouyang W, Poria S, Cambria E, Zhou D. MOOSE-Chem: Large Language Models for Rediscovering Unseen Chemistry Scientific Hypotheses. ICLR 2025. arXiv:2410.07076.
- Liu Y, Yang Z, Xie T, Ni J, Gao B, Li Y, Tang S, Ouyang W, Cambria E, Zhou D. ResearchBench: Benchmarking LLMs in Scientific Discovery via Inspiration-Based Task Decomposition. Findings of the Association for Computational Linguistics: ACL 2026. ACL Anthology 2026.findings-acl.644.
- Si C, Hashimoto T, Yang D. The Ideation-Execution Gap: Execution Outcomes of LLM-Generated versus Human Research Ideas. 2025. Препринт. arXiv:2506.20803.
- Gottweis J, Weng WH, Daryin A, Tu T, et al. Accelerating scientific discovery with Co-Scientist. Nature. 2026;655:487–496. doi:10.1038/s41586-026-10644-y. Дополнительные материалы препринта, версия 2: arXiv:2502.18864v2.
- Huang Y, Mavinkurve A, Sabikunnahar B, Stevens B, Lemke G. Microglia deploy TAM receptors to kill motor neurons in a mouse model of amyotrophic lateral sclerosis. Nature Communications. 2026;17:9837. doi:10.1038/s41467-026-76728-5.
- Phipson B, Smyth GK. Permutation P-values Should Never Be Zero: Calculating Exact P-values When Permutations Are Randomly Drawn. Statistical Applications in Genetics and Molecular Biology. 2010;9(1):Article 39. doi:10.2202/1544-6115.1585.
- Holm S. A Simple Sequentially Rejective Multiple Test Procedure. Scandinavian Journal of Statistics. 1979;6(2):65–70. JSTOR 4615733.
- Panickssery A, Bowman SR, Feng S. LLM Evaluators Recognize and Favor Their Own Generations. Advances in Neural Information Processing Systems. 2024;37. arXiv:2404.13076.
- Luo X, Rechardt A, Sun G, et al. Large language models surpass human experts in predicting neuroscience results. Nature Human Behaviour. 2025;9:305–315. Опубликовано онлайн 27 ноября 2024 года. doi:10.1038/s41562-024-02046-9.
Приложение А. Пять гипотез о гибели двигательных нейронов§
Пример показывает потерю совпадающей гипотезы при отборе (врезка 1). Гипотезы Gemini для задачи R42744804 приведены в исходном порядке генерации; перед предъявлением прогнозирующим моделям их порядок изменили и присвоили им идентификаторы H1–H5. Баллы судей указаны в порядке GPT-5.6 Sol, Claude Opus 5.5 и Grok 4.7. В таблице кратко изложены основные утверждения; модели получали полный текст, сохранённый в исходном отчёте.
| Гипотеза в исходном ответе Gemini▲ | Основное утверждение▲ | Баллы судей▲ | Прогноз Astra▲ | Единогласие четырёх моделей▲ | Случайный контроль▲ |
|---|---|---|---|---|---|
| 1, идентификатор H1 | Микроглия переводит астроциты в состояние, в котором они выделяют токсичные вещества и вызывают гибель двигательных нейронов | 2, 1, 2 | Нет | Нет | Да |
| 2, H2 | Микроглия и макрофаги поглощают ещё живые нейроны после распознавания фосфатидилсерина и компонентов комплемента; среди рецепторов назван MerTK | 3, 4, 4 | Нет | Нет | Да |
| 3, H4 | Стареющие клетки глии выделяют воспалительные вещества, вызывающие гибель двигательных нейронов | 1, 1, 2 | Нет | Нет | Да |
| 4, H3 | Цитотоксические Т-лимфоциты и естественные киллеры распознают и убивают двигательные нейроны | 1, 1, 2 | Да | Нет | Да |
| 5, H5 | Выход митохондриальной ДНК активирует врождённый иммунный ответ и вызывает гибель клеток через образование мембранных пор и перекисное окисление липидов | 1, 0, 2 | Нет | Нет | Да |
Вторая гипотеза совпадает с эталоном при обоих порогах, но все четыре прогнозирующие модели дали ей прогноз «нет». Четвёртая гипотеза получила прогноз «да» от Astra и Grok и прогноз «нет» от Sonnet и Gemini. Поэтому ни одна из пяти гипотез не вошла в итоговый список. Случайный контроль в этом примере дал пять ответов «да»; в решение группы моделей он не входит.
Дополнительные материалы§
Приложения Б–О вынесены в дополнительные материалы: инструкции прогнозирующим моделям (Б), строгий порог совпадения (В), полные показатели сравнения вариантов запроса (Г), ранний прогноз на 2997 гипотезах (Д), полные интервалы двухэтапного отбора (Е), списки одинаковой длины из прогнозов отдельных моделей (Ж), доля верных прогнозов в наборе 50/50 (З), поисковый запрос и журнал отбора публикаций (И), согласие судей (К), дополнительные расчёты отбора и прогнозов (Л), дополнительные сведения о методах (М), дополнительные результаты (Н) и состав опубликованных данных (О).